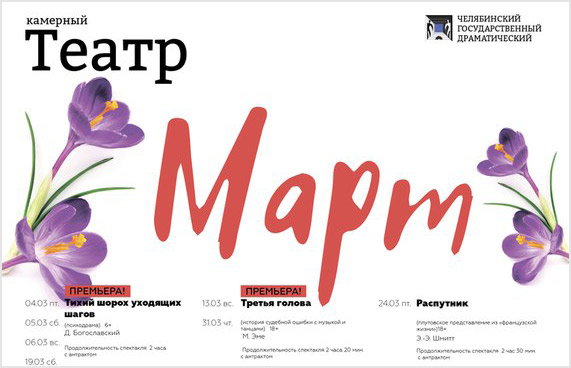
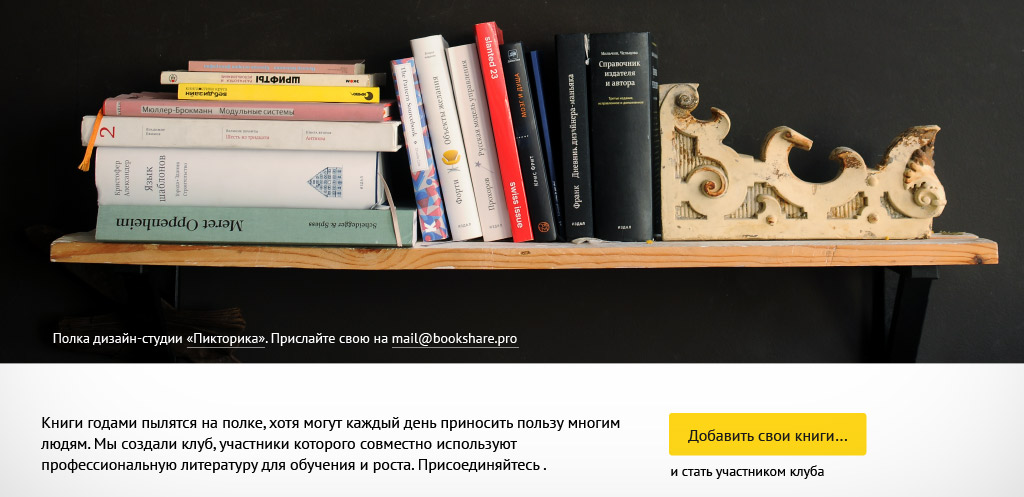
Как можно поставить слово «Март» почти по центру макета, но не совсем?
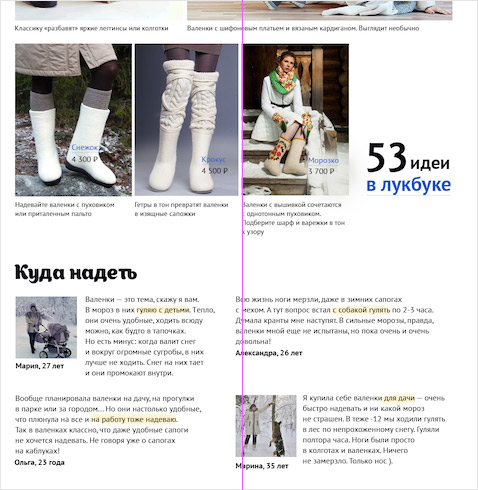
Как можно почти попасть вертикалью, но не совсем?
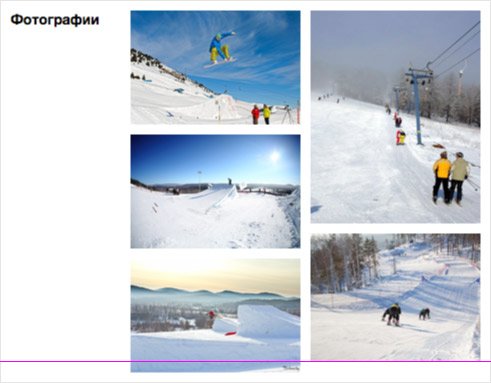
Как можно почти попасть правым столбиком фоток по высоте в левый, но не совсем?
Последние два примера у меня почти одинаковой ширины, но не совсем — специально не стал исправлять.
«Почти, но не совсем» встречается в большинстве макетов начинающих дизайнеров — такие работы выглядят неряшливо. Разумеется, речь здесь не об оптических компенсациях.
Синие кнопки стоят почти напротив друг друга:
Почти, но не совсем. Нужно или выровнять идеально, или, наоборот, развязать ещё сильнее, чтобы было ясно, что так и имелось в виду.
Надписи почти выровнялись левыми краями:
Почти, но не совсем. Нужно или выровнять, или, наоборот, поставить белую надпись по центру иллюстрации.
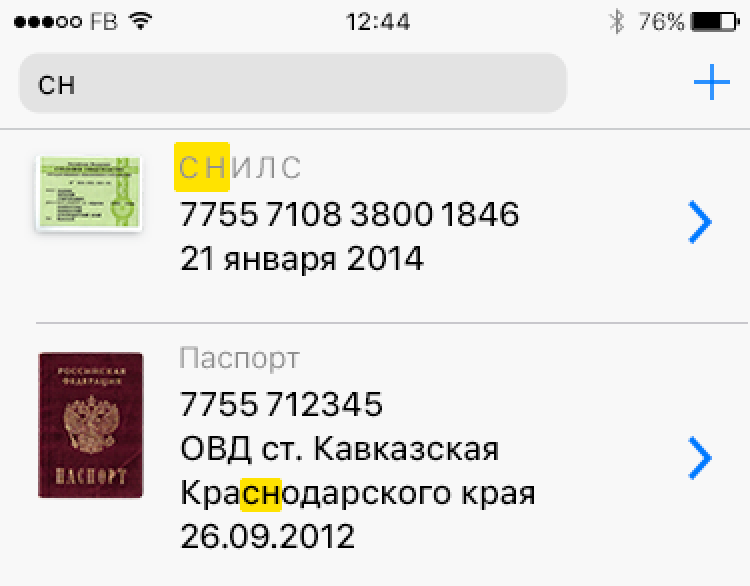
У стрелок вправо угол почти равен 90°:
Почти, но не совсем. Нужно или сделать ровно 90°, или разогнуть ещё сильнее.
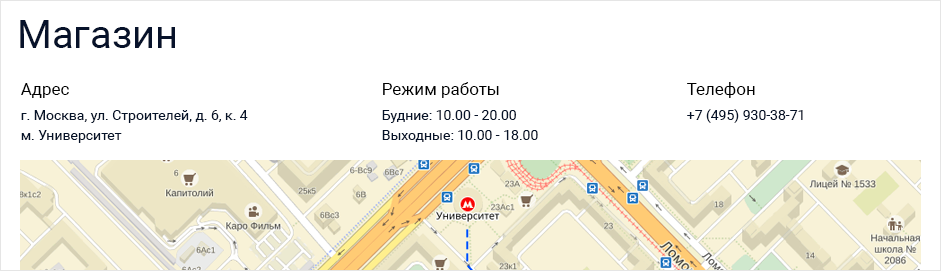
Заголовки «Адрес», «Режим работы», «Телефон» почти такого же кегля, как и текст под ними:
Почти, но не совсем. Нужно или сделать заголовки такого же кегля как текст (и выделить жирным, например), или, наоборот, увеличить ещё сильнее, чтобы не оставалось сомнений.
Тут расстояние между первым и вторым блоком текста почти равно расстоянию между строками текста:
Почти, но не совсем. Нужно или увеличить, или сравнять, иначе кажется что интерлиньяж съехал случайно.
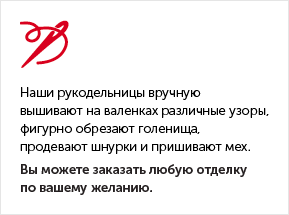
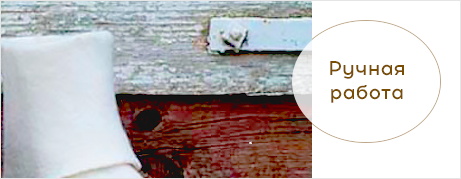
Надпись «Ручная работа» вписана почти в круг:
Почти, но не совсем. Нужно или сделать честный круг, или сильнее сплющить овал, а то кажется, что дизайнер не смог сделать выбор.

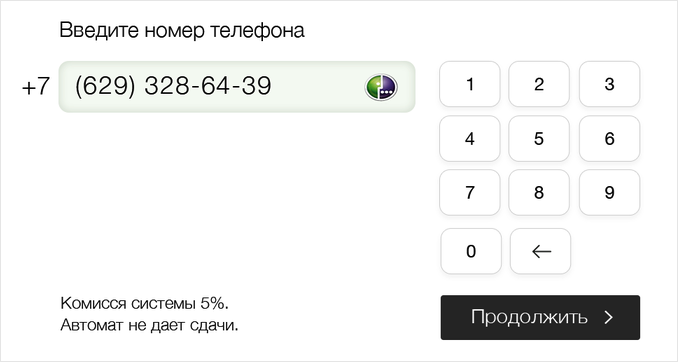
Высота поля ввода почти совпала с высотой кнопок:
Почти, но не совсем. Нужно или сравнять, или увеличить разницу.

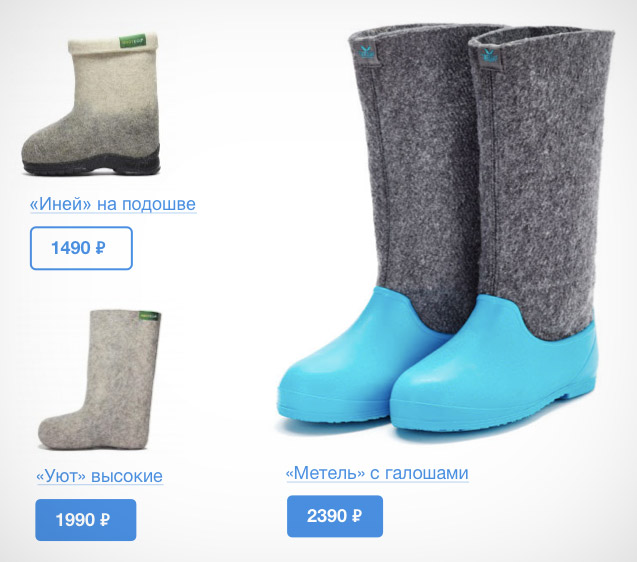
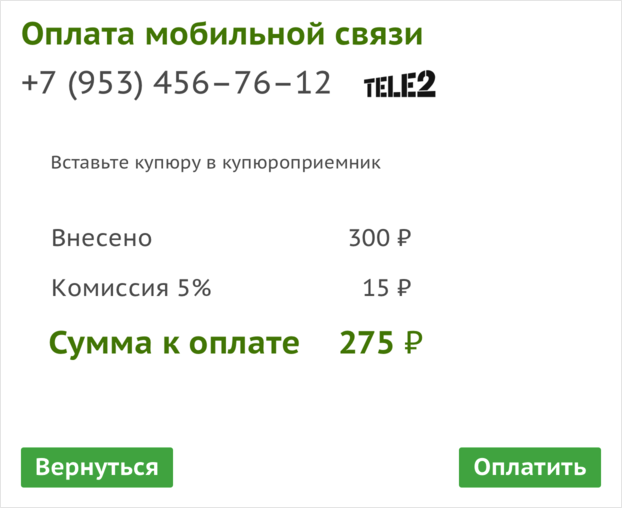
На этом макете используются два почти одинаковых цвета:
Почти, но не совсем. Нужно определиться и сделать цвета или одинаковыми, или разными.
Посмотрел ещё лекцию Зализняка. На этот раз — о происхождении слов:
Что я себе отметил:
37:18. Можете посмотреть, что произошло со словом augustus, чтобы оно на протяжении всего лишь пятнадцати веков превратилось чисто фонетическим путём во французское слово «у» (août).
42:27. Ну и, пожалуй, один пример вам понравится своей действительно большой эффектностью. Английское слово each, каждый. На уровне древнеанглийском это ǣg-hwilc. И тут всё-таки приятно мне вам выписать ещё более глубокий уровень, на этот раз уже прагерманский, который мне придётся пометить звёздочкой, тем не менее вполне надёжно реконструируемый: *aiwa+ga+hwi-līk-az.
1:04:42. Но например для окончаний склонения прекрасно прослеживается и для индоевропейских языков, и, скажем, для угро-финских языков, что в тех случаях, когда удаётся увидеть, откуда взялось окончание, оно оказывается первоначально отдельным словом [...] Кто занимался венгерский языком знает, что падеж инессив (нахождение в чём-нибудь) по-венгерски будет иметь окончание -ben / -ban. Ház — дом, házban — в доме. Но до сих пор в венгерском языке существует слово ben(t?) со значением «середина», «внутренность».
1:09:55. «Мужик», например. Кому из вас кажется, что мужик — это маленький муж? Он совсем не маленький, наоборот, очень даже грубое, крупное такое, сильное существо. Однако ж исторически это уменьшительное от слова «муж»
1:10:36. Например, слово «овца». Мы же совершенно не чувствуем, что овца — это какое-то уменьшительное. А между тем, там уменьшительный суффикс -ц-. Латинское ovis, овца, никакого эквивалента для „ц“ не содержит, там ov просто название овцы. Ясно совершенно, что и в славянском когда-то овца называлась просто «овь». Не осталось от этого слова ничего, вы сейчас бы его не поняли даже, если бы сейчас кто-то стал «овью» называть овцу [...] Мы удовлетворяемся словом «овца». А белорус не удовлетворяется. В белорусском языке нет слова «овца». Белорус овцу называет единственным возможным способом: авечка.
1:12:39. Откуда взялось soleil? При том, что по латыни это sol. Soleil — это продолжение формы soliculum в вульгарной латыни — солнышко.
1:19:28. Вот какое-нибудь я вам могу написать типичное китайскообразное по структуре английское предложение: we can walk down to the city hall. Вполне китайскообразная фраза. В чём её китайскообразность? В том, что у вас каждая единица не имеет никакого телесного окончания [...] Вместе они сопоставлены между собой и образуют фразу. С помощью порядка слов мы прекрасно понимаем, что здесь должно было быть выражено.
1:21:03. А вот пример языка санскритского состояния. Допустим, я напишу так: со-вет-уj-у в-ам по-ех-ах-ть от-дох-ну-ть. Каждое слово, использованное здесь, делится на морфемы с собственным значением. Каждое слово содержит какое-то число морфем, иногда довольно большое. Так что, конечно, русский язык из нынешних является одним из лучших представителей этого типа.
1:31:53. То, что иногда это пишется по-разному в некоторых глаголах (je fais, tu fais, il fait), не меняет того, что на уровне фонетическом в современном французском языке практически все глаголы, кроме вспомогательных (je suis, tu es, il est), имеют это свойство, что всё единственное число одинаково. А пишется по-разному. Je prends, tu prends, il prend пишется по-разному, но, тем не менее, это совершенно одно звучание.
Из зала спросили, что значит этот *aiwa+ga+hwi-līk-az:
1:46:15. Ну, это не так просто. Aiwa первоначально — это тоже самое слово, что век, то есть «всегда». Дальше это уже в готском означает «всегда», «все» — некое обобщающее слово. Ga — это приставка та же, что в немецком ge-, то есть первоначально это эквивалент латинского con-, то есть с-: с-делать, ge-macht и так далее. То есть некоторый в данном случае трудноустанавливаемый оттенок некоей совершенности. Hwi — это «как», «каким образом». Līk — это лик, образ. Hwi+līk — это «какого образа». Значит «всякий, какого образа», вот примерно из каких структур получается each, каждый. «Всеобразный».
С момента выхода 2.5 (v2953) я потихоньку исправлял разные мелочи и заменял на сайте движка дистрибутив. Сейчас там уже лежит сборка v2960 (по ссылке же и инструкция по обновлению).
Вот что изменилось и исправилось:
Лайкли обновились до 2.1.3, где починили счётчик Фейсбука;
картинки-превьюшки, отображаемые в Черновиках и в редакторе под заметкой, стали ретиновыми (заодно дизайн черновиков немного улучшился: превьюшки теперь стоят под обрез);
в одном из файлов шаблонов по ошибке использовался короткий тег ПХП (short_open_tag), хотя я заявлял совместимость с отключенными короткими тегами;
заработали неработавшие иногда поле тегов, Энтер в названии заметки и подвисание карандашика в Хроме;
по ошибке у ответов на комментарии звёздочка ставилась в зависимости от важности комментария, а не ответа;
инсталятор выводил в заголовок окна диагностические сообщения;
максимальный размера загружаемого файла увеличился до 256 мегабайт.
Мне нужно было скопировать структуру папок и файлов с одного диска на другой. Чтобы всё лежало так же по папкам, под теми же именами, но каждый файл весил 0 байт.
Смысл этой операции вот в чём. Изредка мне нужно найти что-нибудь среди файлов десятилетней давности. У меня скопилось несколько жёстких дисков с разными архивами. И есть специальная коробочка, в которую можно вставить жёсткий диск и подключить по УСБ. Меня бесит, что я порой с третьего раза нахожу, на каком из них лежит то, что мне нужно.
Я придумал сделать папки, в которых будет лежать полная файловая структура каждого из моих жёстких дисков без самих данных. Тогда я смогу мгновенно находить любой файл по имени спотлайтом, а уже потом сразу втыкать жёсткий диск с настоящим файлом.
Пришлось попотеть, чтобы понять, как это сделать. У меня получилось так:
cd папка_которую_клонируем
find . -type d -print0 | xargs -0 -I {} mkdir -p папка_куда_клонируем/{}
find . -type f -print0 | xargs -0 -I {} touch папка_куда_клонируем/{}
Сложность была в том, что find возвращает список найденных файлов с пробелами в именах, и когда такие файлы передаёшь куда-то ещё, всё взрывается. Пришлось просить find в конце имени каждого найденного файла ставить символ 0 (-print0), а потом с помощью адской команды xargs это разбирать и скармливать в качестве аргументов другим командам. Учитывая, что я раньше ничего сложнее apachectl restart не писал, это была жесть.
Добавлено через полчаса: Читатели рассказали мне про -exec
Это отличный трек Джерома Исмы-Эя «Индиго» (2005):
Одна из первых вещей в жанре прогрессив-хаус, которую я распробовал, и первое, что я услышал у Исмы. До сих пор остаётся эталоном, имеет пять звёзд в моей коллекции и входит в золотой фонд.
Люблю случайно изучать языки. В данном случае я даже не сразу узнал, о каком языке речь. Сначала почему-то подумал, что об испанском, но потом дошло, что об итальянском.
Так вот. Есть такая дурацкая, но клёвая песня:
Самый кайф после 2:30, но сейчас нас интересует не это. В 1:13 там начинается какой-то текст про дискотеку. Мне в общем-то пофиг на текст, но когда я на третий раз услышал «Domenica... a la discoteca» у меня щёлкнуло: «А, так domenica — это воскресенье? Это ж почти как dimanche по-французски».
И тут я понял, о чём эта песня. Песня-разгадка (ещё клёвее):
«Lunedi sera, la discoteca» — ну блин, мог бы и с первого раза понять, учитывая, что lundi — это понедельник по-французски, а buonasera — добрый вечер по-итальянски.